— GR00T 2 aprende viendo a los humanos: 40 % de éxito sin entrenamiento específico para la tarea, 71 % con una demostración y 95 % con cinco.
— La clave es X-Adapt: transfiere habilidades entre cuerpos distintos, de una mano humana a una mano robótica de cinco dedos.
— El matiz: los pesos y el código llegan en diciembre, y una evaluación independiente midió 12,8 % en el mundo real frente al 95 % anunciado.
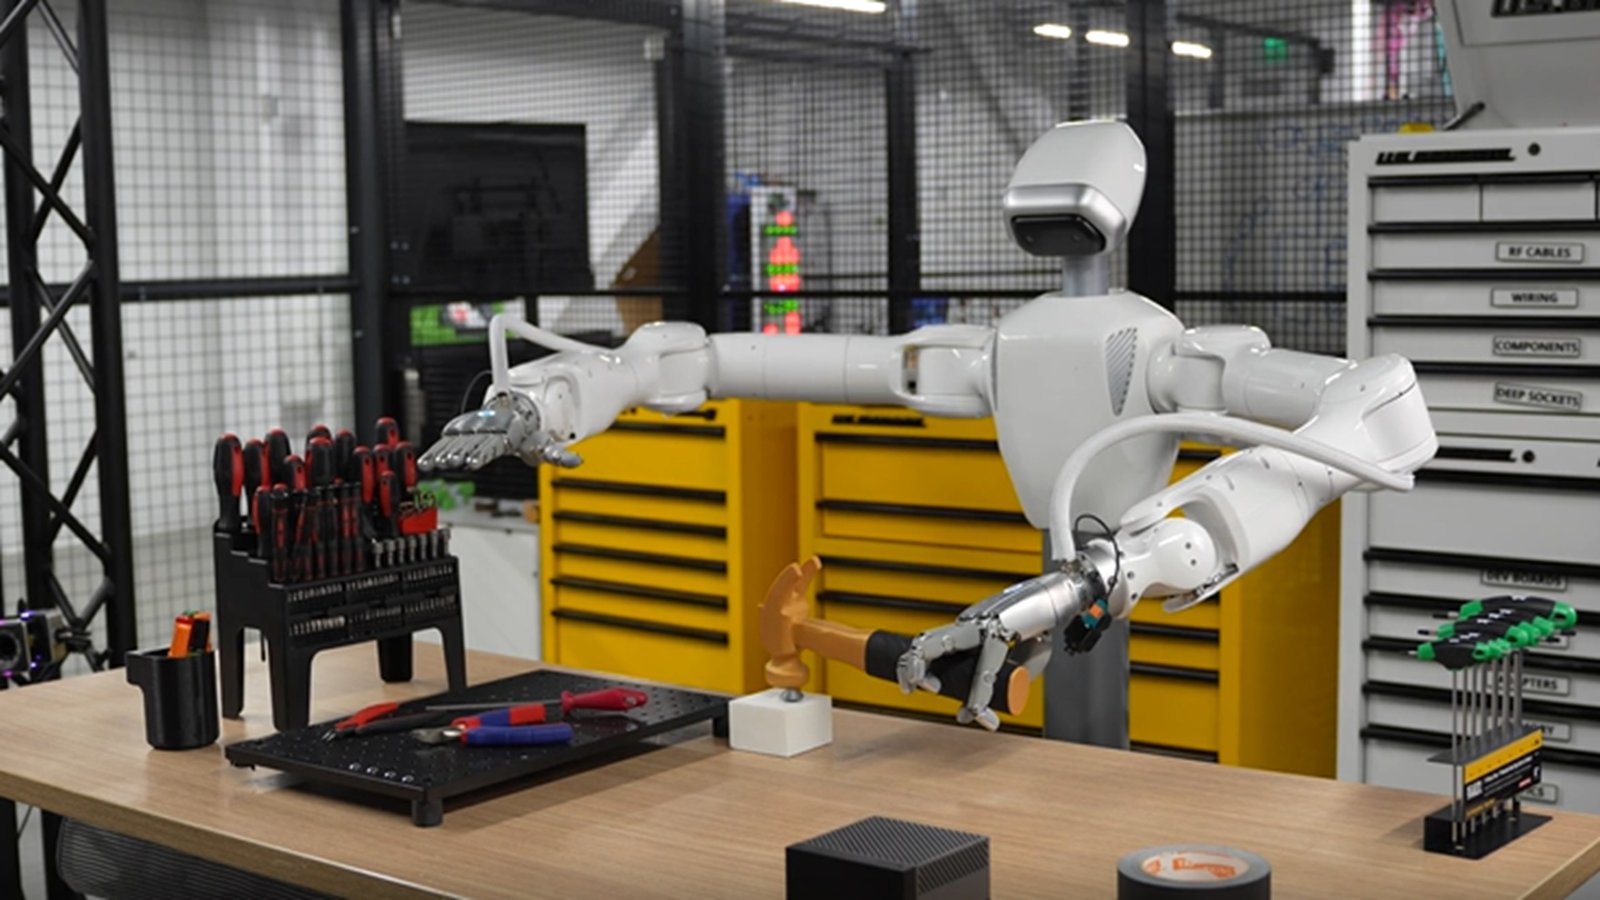
NVIDIA presentó en la Conferencia de Aprendizaje de Robots (CoRL), en Austin, Texas, GR00T 2, un modelo fundacional para robots que aprende a manipular objetos viendo vídeos en primera persona de humanos, en lugar de depender de que cada robot practique la tarea una y otra vez. Es lo que la empresa llama un world-action model (modelo mundo-acción): predice a la vez los próximos fotogramas de vídeo y los movimientos del robot, así que «imagina» cómo se desarrolla la interacción física y luego ejecuta las acciones que imaginó, según Interesting Engineering.
Los números que NVIDIA puso sobre la mesa son estos: en 50 tareas que el robot nunca había practicado, el modelo completó al menos una vez 40 de ellas sin ninguna demostración específica, con un 40 % de éxito medio. Con una sola demostración por tarea, el promedio subió a 71 %, y con cinco demostraciones llegó a 95 %, con 37 tareas resueltas en todos los intentos. El ajuste fino para esas cinco demostraciones toma 30 minutos en una sola tarjeta gráfica RTX 5090 y menos de tres minutos de datos del robot por tarea.
La pieza que hace distinto a GR00T 2 es X-Adapt, la transferencia entre cuerpos: el robot aprende de demostraciones hechas con un cuerpo o un dispositivo diferente al suyo. En un experimento, solo un humano —sin teleoperar el robot— mostró cómo forrar un embudo de laboratorio con papel filtro y mojarlo con una piseta; la mano robótica de cinco dedos completó la tarea en el 65 % de los intentos. En otro, un gripper manual (UMI) demostró cómo armar un camión de juguete y un brazo distinto, llamado YAM, lo armó en el 60 % de los intentos sin haber recibido jamás una demostración para esa tarea. También usaron un dispositivo vestible que refleja los movimientos de los dedos de una persona para enseñar tareas con dos manos, como preparar yogur de plátano con granola o encender una lámpara con una cerilla.
El modelo se entrenó con una escala de datos poco habitual: 402.730 horas de vídeo humano en primera persona, 10.184 horas de demostraciones con gripper manual y 23.500 horas de teleoperación de robots. NVIDIA dice que 100.000 horas de su conjunto de datos Human-1M están disponibles abiertamente. GR00T 2 tiene 2.000 millones de parámetros y está construido sobre Cosmos, la plataforma de modelos de mundo de NVIDIA.
GR00T 2 también trabaja con modelos de razonamiento que descomponen tareas complejas en pasos, vigilan el avance y dirigen al robot. En tres ensambles de juguetes, ese enfoque completó al menos 97 de 100 intentos por juguete, con capacidad de recuperarse de errores e interrupciones. Una función de guía visual —el modelo marca dónde agarrar y soltar— elevó el éxito en tareas cortas del 40 % al 92 % en el brazo YAM. NVIDIA presentó además GR00T 2 Turbo, una versión más ligera que corre directamente en el humanoide Unitree G1 con un procesador Jetson Thor a bordo, con 124 milisegundos por predicción: sirvió palomitas en los 48 intentos y despejó una mesa de objetos diversos en el 93 % de los casos.
Junto al modelo llegó Isaac Lab 3.0, el marco de aprendizaje de robots de código abierto, que según NVIDIA alcanza hasta 2,5 veces el rendimiento de entrenamiento de la versión anterior. También se estrenaron dos bancos de pruebas industriales, DexBench y VABAR, y el modelo se ubica entre los tres primeros en las categorías de modelos de visión-lenguaje-acción y de modelos mundo-acción. «La robótica agentic es el desarrollo tecnológico más emocionante desde internet en 1995», dijo Ken Goldberg, profesor de robótica de UC Berkeley, que lidera el trabajo de VABAR. Entre los colaboradores del anuncio están Ambi Robotics, Bosch Research, Flexion, FieldAI y Siemens, y ya hay pilotos industriales en marcha con Foxconn, Siemens y Nexuni.
Lo prometido vs. lo entregado: el 95 % es la cifra de NVIDIA en sus propias pruebas, y conviene leerla con el matiz que la propia cobertura señala: las tareas evaluadas fueron preseleccionadas con una capacidad base alta, y una evaluación independiente de RoboDojo midió 12,8 % de éxito en el mundo real frente al 95 % anunciado, una brecha que no se podrá auditar hasta diciembre, cuando se publiquen los pesos y el código. NVIDIA tampoco ha publicado aún los términos de la licencia ni la lista completa de las 50 tareas. Dicho eso, el cambio de fondo no depende de la cifra: enseñar a un robot mostrándole el trabajo, en vez de programarlo o teleoperarlo durante horas, cambia quién puede entrenarlo.
Qué significa para América Latina: la región no compite en fabricar humanoides, pero sí en usarlos. México, con su base manufacturera y el nearshoring, es uno de los lugares donde un robot adaptable aterriza primero: líneas de ensamble, almacenes y logística, donde cada cambio de producto hoy exige reprogramar o reentrenar. Si el entrenamiento se reduce a que un operario muestre la tarea cinco veces con las manos, el costo de entrada baja para las fábricas medianas, no solo para las grandes. Y hay un punto que toca directamente a la comunidad latina: el trabajo que se enseña con el cuerpo —el del operario— se convierte en el dato que entrena a la máquina, así que la pregunta de quién se beneficia de ese conocimiento es tan importante como la tecnología misma.
Qué NO se cubre: esto no es un producto a la venta. No hay precio, ni fecha de comercialización, ni un robot que se pueda comprar: es un modelo de investigación con pilotos industriales, cuyos pesos, código y receta de entrenamiento llegan en diciembre.
Qué sigue: en diciembre se publican los pesos de GR00T 2 y de GR00T 2 Turbo, junto con el código y la receta de X-Adapt. Ahí será cuando investigadores independientes puedan comprobar si el 95 % se sostiene fuera del laboratorio y si el modelo aprende igual de bien en fábricas reales que en los bancos de pruebas.
Fuentes y créditos:
Interesting Engineering: NVIDIA's GR00T 2 lets robots learn tasks from humans, not machines
NVIDIA Blog: Practice Makes Precise — GR00T 2 at CoRL
GR00T 2: NVIDIA enseña a los robots viendo vídeos de humanos